
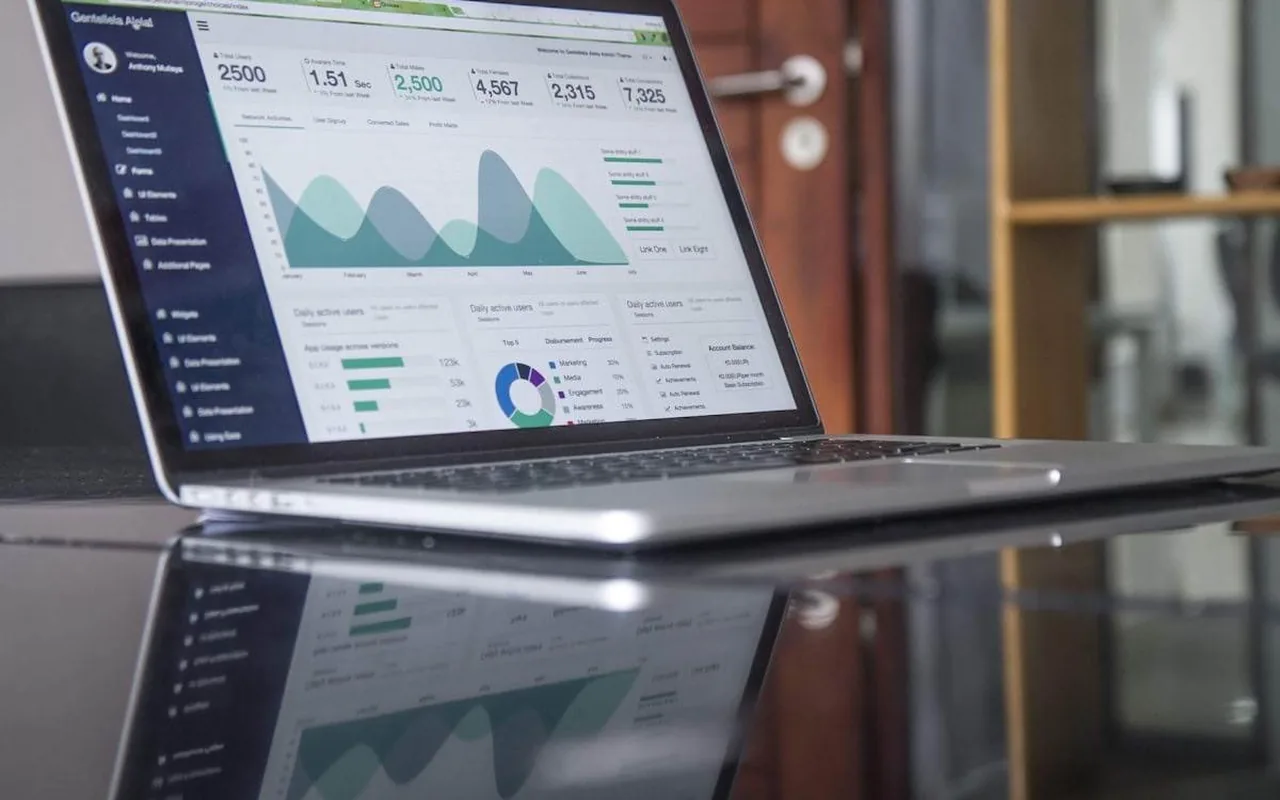
指标要能定位问题
只看调用量没有意义,要按任务成功率、人工接管率与平均处理时长分场景统计。指标必须能下钻到错误类型,否则团队只知道结果变差却不知道差在哪里,运营会陷进无休止的猜测,也看不出该改数据、改流程还是换模型。
知识更新是日常动作
指定一名知识负责人,按周处理过期条目、补充新问题,并把用户提问中检索不到的高频问题回流成待办。没有这条通路,知识库会在两三个月内与实际业务脱节,回答质量随之缓慢下滑,而且很难被察觉。
提示词与模型要版本化
每次调整提示词、检索策略或底层模型,都要记录版本号、变更原因与回归结果。没有版本记录时,一次看似微小的改动可能让某类问题的表现明显变差,而排查要花掉数倍于改动本身的时间,最后只能整体回滚。
回归评测固定节奏
把评测集按周或按双周跑一次,对比成功率与错误类型的分布变化。只在出问题时才评测,等于放弃早期发现;固定节奏的小成本回归,比事故后的全面排查便宜得多,也更容易形成可比较的历史曲线,供季度复盘使用。
成本与调用量要看得见
按场景统计调用量、平均长度与失败重试次数,识别异常放大与无效循环。成本失控往往不是单价问题,而是重试、长上下文与重复调用叠加出来的,缺少监控时通常在上线两三个月后才被发现,那时已经很难追溯原因。
适用与不适用
适合谁
- 已上线、需要建立日常运营机制的团队
- 多场景并行、需要统一指标口径的企业
- 准备把系统整体交给内部 IT 接手的项目
不适合谁
- 仍处于原型验证、尚未有真实用户的阶段
- 希望上线后完全无人维护、只按调用付费的部门
典型场景
某保险公司的理赔材料预审助手在试运行期表现稳定,正式接手后由运营岗每周跑一次回归、更新一次知识条目。第三个月发现某类新险种的材料清单未入库,接管率上升,补充知识后回落。团队把这次问题写进季度复审记录,并调整了新险种上线时的知识同步流程,避免同类问题再次出现。
可执行步骤
- 上线首月按场景统计成功率、接管率与平均处理时长,形成基线,作为后续对比的基线
- 指定知识负责人,建立每周更新与问题回流的固定动作,并留出固定工时
- 给提示词、检索策略与底层模型建立版本记录与变更说明,便于回退与对比
- 固定双周回归评测,输出错误类型分布的对比结果并归档,并纳入季度复盘
常见坑
- 只监控服务是否可用,不监控回答质量,系统明明在退化却没人知道,直到投诉集中出现才开始排查。
- 知识更新靠临时突击,新政策上线后一整批回答过期,用户投诉之后才被发现,信任已经受损;恢复成本很高。
- 改动不留版本,出错时无法回滚,只能凭记忆逐个试回去,排查时间往往超过改动本身;影响面难以控制。
- 成本只看月度总额,不按场景拆分,异常调用被平均值掩盖,等问题显现时已连续数月超支;事后无法解释。
自检与验收清单
- 是否有分场景的成功率与接管率统计基线,并有明确口径
- 知识更新是否有责任人与固定的更新频率,是否有人实际执行
- 每次改动是否留版本号与回归评测结果,是否可追溯到版本
- 成本是否按场景拆分并可下钻到调用类型,是否覆盖主要场景
常见问题
上线后还需要投入多少人?
通常一名兼职运营加一名知识负责人即可覆盖单场景,主要工作是处理问题回流、更新知识与看指标;场景越多、业务变化越快,投入越高,建议按场景核定人力而不是按系统核定,否则很容易低估实际负担。
接管率多少算正常?
与场景风险相关,高风险场景接管率天然更高。建议先记录上线首月的基线,再观察变化趋势,而不是套用外部数字;趋势持续上升通常说明知识或流程出现了缺口,应及时排查而不是调低阈值。
什么时候该做模型升级?
当现有模型在评测集上出现明确的能力瓶颈,且升级能解决具体错误类型时再升级。为追新而频繁换模型,会让版本对比失去意义,运维成本也会显著上升,最终没有人说得清哪个版本更好。